Category Archives: Metabolomica

PhDays 2026

C’è fermento nel nostro Dipartimento!

Il 2 e 3 novembre 2026 si terrà presso il Polo scientifico dell’Università degli Studi della Campania “Luigi Vanvitelli” il 2nd Emerging Trends in Biomolecular Sciences, evento centrale dei PhD Days 2026. Di seguito la locandina e il link al sito web dell’evento: https://phdays25.wordpress.com/

Tutti gli studenti del DiSTABiF sono invitati a partecipare!

Nel corso del PhDays, i dottorandi illustreranno e discuteranno con i loro colleghi e con i docenti e ricercatori i progressi fatti nel corso della loro attività di ricerca. Si tratta di un momento cruciale per loro, ma che può essere interessante anche per tutti gli studenti, soprattutto coloro che sono iscritti ai Corsi di Laurea Magistrale o agli ultimi anni del Corso di Laurea in Farmacia.

Ascoltando le relazioni dei dottorandi, potrete avere un’idea di quella che è l’attività di ricerca svolta presso il nostro Dipartimento. Tra l’altro, presto vi troverete di fronte a scelte importanti e potrebbe essere interessante capire, grazie al confronto con i vostri colleghi più grandi, se ad esempio l’attività di ricerca possa essere per voi una via percorribile.
Inoltre, molto spesso non abbiamo ben chiaro neppure cosa sia il dottorato di ricerca: quale occasione migliore per confrontarsi con chi lo vive? Anche i docenti saranno presenti e sicuramente aperti a rispondere a qualsiasi vostra domanda (durante e dopo l’evento).

Infine, a breve probabilmente vi troverete nella condizione di scegliere in quale laboratorio svolgere la vostra attività di tesi. Questo punto è importante soprattutto per coloro che devono fare una tesi sperimentale o metodologica, per le quali è necessario frequentare un laboratorio. Molto spesso la scelta viene fatta con poca consapevolezza, magari puntando al “minimo sforzo, massima resa”, oppure si sceglie semplicemente seguendo il consiglio degli altri…o, ancora peggio, sentendosi obbligati dall’invito di un docente a fare la tesi nel proprio laboratorio. Perchè non fare una scelta più consapevole, basata su un reale interesse verso l’attività di ricerca?
Il PhDays è una finestra aperta sul dipartimento, che vi permette di avere almeno un’idea di cosa si fa in diversi laboratori del DiSTABiF.

Sul sito dell’evento è disponibile anche il programma dettagliato dell’evento: https://phdays25.wordpress.com/program/, che si concluderà con un momento conviviale.
Oggi, niente Chimica Organica…ma qualcosa su cui riflettere

Oggi non saranno pubblicati nuovi contenuti di Chimica Organica.

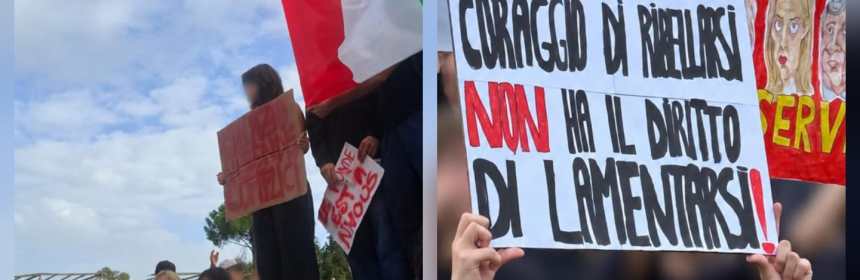
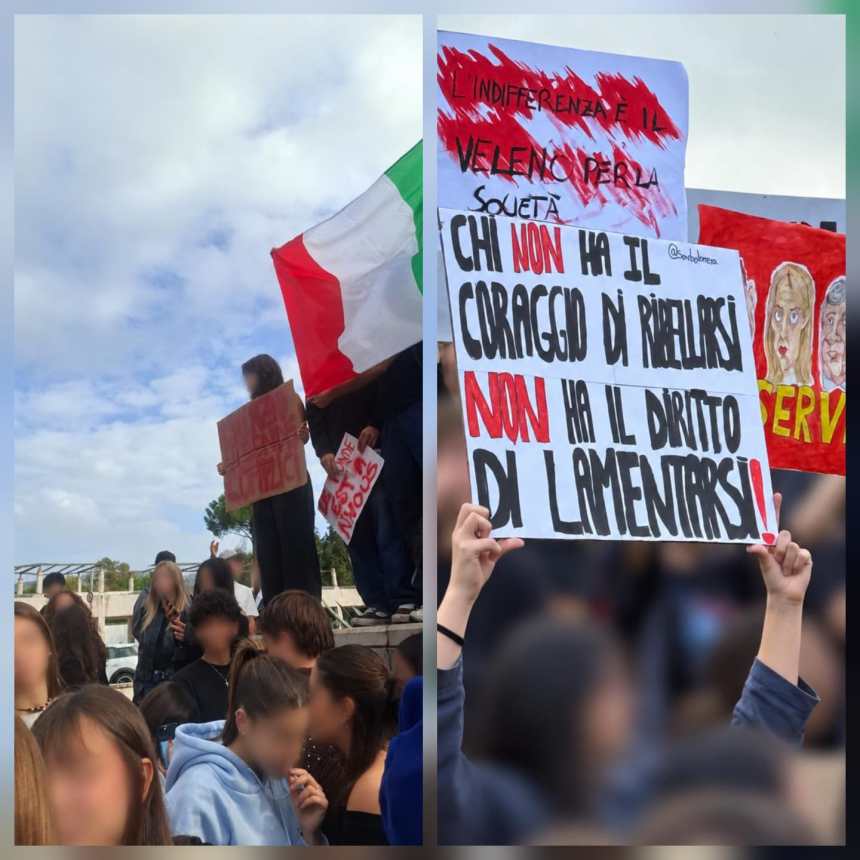
Vogliamo invece condividere due frasi riportate su altrettanti cartelloni presenti alla manifestazione degli studenti delle scuole di Caserta di questa mattina.

Forse nelle immagini non si leggono bene, quindi le trascriviamo:

«Il silenzio rende complici»

«Chi non ha il coraggio di ribellarsi non ha il diritto di lamentarsi»

Due frasi forti, che crediamo meritino una riflessione.

In questi giorni si è scelto di ricorrere alla didattica a distanza per garantire la continuità delle lezioni nonostante la mobilitazione in corso. Una soluzione che, a nostro avviso, presenta due problemi.

Il primo è didattico: soprattutto in insegnamenti come Chimica Organica, la didattica a distanza non può sostituire con la stessa efficacia il confronto diretto, la discussione e l’interazione che caratterizzano una lezione in presenza.

Ma il secondo è ancora più importante. Di fronte a una protesta, limitarsi a trovare il modo di proseguire le proprie attività significa rischiare di ignorare le ragioni stesse della mobilitazione e di indebolirne il significato.

A voi studenti vorremmo dire una cosa. Vi chiediamo ogni giorno di ragionare, di porvi domande, di non accontentarvi di risposte imparate a memoria. Ma queste capacità non servono soltanto a comprendere la Chimica Organica. Servono soprattutto a comprendere il mondo in cui vivete e a decidere quale ruolo volete avere al suo interno.

Non vi chiediamo di condividere le nostre idee o le nostre scelte. Vi chiediamo di non rinunciare mai a farvi delle domande, a confrontarvi e a prendere posizione quando lo ritenete giusto. Perché l’indifferenza è anch’essa una scelta, e anche scegliere di non fare nulla può avere delle conseguenze.

Nei prossimi giorni riceverete ulteriori informazioni sull’organizzazione delle attività didattiche. Ma per oggi, niente Chimica Organica. Oggi lasciamo spazio alla riflessione.

Proff. Monica Scognamiglio e Antonio Fiorentino

Spettrometria di massa e spettroscopia NMR – Test preliminare

Prima di iniziare la parte del corso di Metabolomica dedicata alla spettrometria di massa e alla spettroscopia NMR, vi propongo un breve test per verificare le vostre conoscenze preliminari su questi argomenti.

Il test comprende 30 domande a risposta multipla, dedicate ai principi fondamentali delle due tecniche e ad alcuni aspetti dell’interpretazione dei dati.

A cosa serve?

Non si tratta di una prova di valutazione e il risultato non avrà alcun effetto sul corso o sull’esame. Le risposte serviranno semplicemente a capire quali concetti sono già noti e quali sarà utile riprendere o approfondire durante le lezioni.

Vi chiedo quindi di rispondere senza consultare libri, appunti o altre fonti: non importa quante risposte saranno corrette, ma avere un quadro realistico delle conoscenze di partenza.

👉 Compila il test

IL form si chiuderà domenica 11 Ottobre alle 12:00

Cromatografia – Test preliminare

Prima di iniziare la parte del corso dedicata all’utilizzo della cromatografia in metabolomica, vi propongo un breve test per verificare le vostre conoscenze preliminari sull’argomento.

Il test comprende 30 domande a risposta multipla sui principi generali della cromatografia e sulle principali tecniche cromatografiche.

🎯 A cosa serve?
Non è una prova di valutazione e il risultato non avrà alcun effetto sul corso o sull’esame. Le risposte serviranno semplicemente a capire quali concetti sono già noti e quali, invece, sarà utile riprendere o approfondire durante le lezioni.

Vi chiedo quindi di rispondere senza consultare libri, appunti o altre fonti: non importa quante risposte saranno corrette, ma avere un quadro realistico delle conoscenze di partenza.

👉 Compila il test

IL form si chiuderà domenica 4 Ottobre alle 12:00

PSE Meeting 2026 a Caserta

Dal 15 al 18 settembre 2026, Caserta ha ospitato il PSE Annual Meeting 2026, il congresso annuale della Phytochemical Society of Europe, una delle principali società scientifiche internazionali dedicate allo studio delle sostanze naturali.

L’edizione 2026, dal titolo Phytochemistry for a Sustainable Future: Bridging Nature, Innovation, and Health, è stata organizzata dall’Università degli Studi della Campania “Luigi Vanvitelli”, con i Proff. Monica Scognamiglio e Antonio Fiorentino come Chairs del congresso e il coinvolgimento di un Comitato Organizzatore composto da docenti e ricercatori del DiSTABiF.

All’organizzazione scientifica ha contribuito inoltre un Comitato Scientifico internazionale, costituito da ricercatori provenienti da numerose università e istituzioni europee. Fondamentale è stato anche il contributo dello staff tecnico e degli studenti, dottorandi e giovani ricercatori del Dipartimento, coinvolti nelle diverse fasi dell’organizzazione e, durante il congresso, nella gestione delle sessioni scientifiche e delle numerose attività previste dal programma.

Per quattro giorni, ricercatori provenienti da diversi Paesi si sono incontrati a Caserta per discutere alcuni dei temi più attuali della ricerca nel campo della fitochimica e delle sostanze naturali.

Il programma scientifico ha spaziato dalla scoperta, isolamento e sintesi di prodotti naturali allo studio del metabolismo, dalla chemical ecology e dalle interazioni tra piante alle applicazioni delle sostanze naturali nella drug discovery e nella salute umana, fino a nutraceutici, functional foods, sistemi avanzati di formulazione e nuove strategie basate sull’intelligenza artificiale.

Accanto alle invited lectures e alle comunicazioni orali, una parte importante del congresso è stata dedicata alle presentazioni poster e ai giovani ricercatori. Alcuni dei poster, selezionati attraverso una votazione durante il congresso, sono stati inoltre presentati come brevi Flash Oral Presentations.

Il programma è stato preceduto, nella mattina del 15 settembre, da un workshop dedicato alla Centrifugal Partition Chromatography (CPC), una tecnica di separazione particolarmente interessante per l’isolamento e la purificazione delle sostanze naturali.

Ma cosa c’entra tutto questo con la Chimica Organica?

Molto più di quanto possa sembrare.

La chimica delle sostanze naturali è, prima di tutto, Chimica Organica.

Le piante e gli altri organismi viventi producono un’enorme varietà di molecole organiche: terpeni, alcaloidi, flavonoidi, saponine, polifenoli e moltissime altre classi di composti.

Isolare queste molecole, determinarne la struttura, comprenderne la stereochimica e la reattività significa applicare proprio i principi fondamentali della Chimica Organica.

I gruppi funzionali, la stereochimica, le relazioni tra struttura e proprietà e i meccanismi di reazione che si incontrano durante un corso universitario diventano così gli strumenti necessari per affrontare molecole reali, spesso estremamente complesse.

Ma studiare una sostanza naturale significa anche andare oltre la sua struttura.

Perché un organismo produce quella particolare molecola? Quale funzione svolge?

Molti metaboliti specializzati sono coinvolti nella difesa da erbivori e patogeni, nell’attrazione degli impollinatori, nella comunicazione tra organismi o nelle risposte alle condizioni ambientali. Altri mostrano proprietà biologiche che possono renderli interessanti come punto di partenza per applicazioni farmaceutiche, alimentari, cosmetiche o biotecnologiche.

La fitochimica moderna nasce quindi dall’incontro tra discipline diverse, ma conserva al centro una domanda profondamente chimica: come possiamo comprendere una molecola a partire dalla sua struttura?

PSE 2026 in breve

PSE 2026 è stato soprattutto un’occasione per riunire a Caserta una comunità scientifica internazionale e mettere in contatto esperienze, approcci e generazioni diverse di ricercatori. Per il DiSTABiF è stata anche l’opportunità di accogliere questa comunità nei propri spazi e di coinvolgere direttamente giovani ricercatori e studenti nella vita di un congresso scientifico internazionale.

Il congresso si è concluso il 18 settembre, ma il suo racconto continua online: sul sito ufficiale sono disponibili il programma, il Book of Abstracts, le informazioni sulle diverse iniziative e gli aggiornamenti legati all’evento. Un’occasione anche per chi non ha partecipato per dare uno sguardo più da vicino alla ricerca contemporanea nel campo della fitochimica e delle sostanze naturali.

Per approfondire: PSE Annual Meeting 2026 – sito ufficiale

Metabolomics Data Analysis

Nel contesto della metabolomica, gli approcci di analisi statistica più comuni si suddividono in metodi univariati e multivariati. Ogni metodo offre approfondimenti unici sulla struttura dei dati. L’analisi multivariata opera su una matrice di variabili e mette in evidenza le caratteristiche basandosi sulle relazioni tra tutte le variabili. L’analisi univariata considera invece una sola variabile alla volta, producendo risultati ponderati in modo diverso.

L’obiettivo dell’analisi statistica è la categorizzazione e la previsione delle proprietà dei campioni attraverso la generazione di modelli che catturano le informazioni contenute nelle matrici di dati. Nella spettrometria di massa, il rapporto m/z e l’intensità del segnale sono le due variabili più importanti. Nell’NMR selezioniamo i segnali integrati di interesse per l’analisi dei dati.

Nell’ambito dell’analisi multivariata, distinguiamo metodi supervised e unsupervised come i due principali approcci di analisi statistica e machine learning utilizzati per analizzare i dati.

Metodi Unsupervised

I metodi unsupervised non richiedono etichette o variabili di output predefinite. L’obiettivo è esplorare la struttura intrinseca dei dati, trovando pattern, gruppi o caratteristiche rilevanti.

Caratteristiche principali:

  • No etichette: Non esistono etichette a priori; i metodi cercano di individuare somiglianze o differenze nei dati.
  • Scoperta di pattern: Sono utilizzati per esplorare i dati e identificare raggruppamenti naturali o ridurre la dimensionalità.
  • Esempi di metodi unsupervised:
    • Clustering: Algoritmi come Hierarchical Clustering dividono i dati in gruppi basati su similarità.
    • Riduzione della dimensionalità: Metodi come PCA (Principal Component Analysis) semplificano la rappresentazione dei dati preservandone le caratteristiche principali.

Metodi Supervised

I metodi supervised richiedono un set di dati etichettati, in cui ogni campione è associato a un’etichetta o a una variabile di output nota (ad esempio, classe, valore numerico, ecc.). L’obiettivo principale è costruire un modello che sia in grado di prevedere accuratamente l’etichetta per nuovi dati non etichettati.

Caratteristiche principali:

  • Training su dati etichettati: Si utilizza un insieme di dati noti (training set) per apprendere la relazione tra le variabili indipendenti (input) e le etichette (output).
  • Predizione: Una volta addestrato, il modello può essere utilizzato per prevedere le etichette di nuovi campioni.
  • Esempi di metodi supervised in metabolomica: PLS-DA (Partial Least Square – DIscriminant Analysis)

Analisi delle Componenti Principali (PCA)

L’Analisi delle Componenti Principali (PCA, Principal Component Analysis) è una tecnica di riduzione della dimensionalità utilizzata per semplificare set di dati complessi preservandone le caratteristiche più rilevanti. È ampiamente impiegata in numerosi campi, come la metabolomica, la genetica, l’analisi di immagini, e altre discipline che gestiscono dati ad alta dimensionalità.

Obiettivo della PCA

La PCA mira a trasformare un set di dati originale (caratterizzato da molte variabili correlate) in un nuovo sistema di coordinate, chiamato componenti principali. Queste componenti:

  1. Sono ortogonali (non correlate tra loro).
  2. Catturano la varianza massima: la prima componente principale (PC1) cattura la maggior parte della varianza nei dati, seguita dalla seconda (PC2), e così via.

Questo processo consente di rappresentare i dati con un numero inferiore di variabili, riducendo la complessità ma mantenendo la maggior parte dell’informazione.
Come vengono calcolate le componenti principali? Vedi il materiale presente al link “DATA ANALYSIS” sotto per io dettagli. Fondamentalmente, si scelgono le componenti principali che spiegano una frazione significativa della varianza totale (ad esempio, il 95%) e i dati originali vengono trasformati nel nuovo sistema di coordinate formato dalle componenti principali.

Grafici principali nella PCA

1. Score Plot

Lo score plot mostra la proiezione dei campioni nello spazio delle componenti principali selezionate (ad esempio, PC1 e PC2).

  • Cosa rappresenta:
    • Ogni punto nel grafico corrisponde a un campione nel dataset.
    • Le coordinate di un campione sul grafico rappresentano i suoi punteggi (scores), ovvero i valori proiettati sulle componenti principali.
  • Utilità:
    • Identifica pattern nei dati: ad esempio, raggruppamenti naturali, tendenze, o separazioni tra gruppi (es. malati vs sani).
    • Aiuta a rilevare outlier o campioni anomali.
  • Esempio:
    • Un gruppo di campioni che si aggregano in una regione dello score plot può indicare una similarità tra di essi (ad esempio, appartenenza a una stessa classe).

2. Loading Plot

Il loading plot rappresenta i carichi (loadings), ovvero i coefficienti che descrivono il contributo delle variabili originali (metaboliti, geni, ecc.) alle componenti principali.

In uno studio metabolomico, un loading plot potrebbe evidenziare quali metaboliti sono responsabili della separazione tra gruppi di campioni osservata nello score plot.

Cosa rappresenta:

Ogni punto nel grafico corrisponde a una variabile originale. La posizione di una variabile indica quanto questa contribuisce a ciascuna componente principale.

Un loading plot sotto forma di istogramma è una rappresentazione alternativa dei carichi (loadings) che descrivono il contributo delle variabili originali (ad esempio, metaboliti, geni, segnali) a una specifica componente principale (PC). Invece di visualizzare i carichi come punti o vettori su un piano cartesiano (come accade nel loading plot tradizionale), in un istogramma ogni barra rappresenta il peso di una variabile su una determinata componente principale.

Caratteristiche del Loading Plot a Istogramma

  • Asse X:
    • Rappresenta le variabili originali (es. nomi o numeri che identificano i metaboliti, geni, o segnali di interesse).
    • Ogni barra corrisponde a una variabile.
  • Asse Y:
    • Indica il valore del carico (loading), che può essere positivo o negativo.
    • I valori positivi mostrano una correlazione diretta con la componente principale, mentre i valori negativi indicano una correlazione inversa.
  • Altezza delle barre:
    • La lunghezza di ciascuna barra rappresenta il contributo della variabile alla specifica componente principale.
    • Variabili con barre più alte (in valore assoluto) hanno un’influenza maggiore sulla componente.

Utilità:

Identifica le variabili che influenzano maggiormente le componenti principali. Aiuta a interpretare la biologia o il fenomeno dietro ai pattern osservati nello score plot. Rileva correlazioni tra variabili: variabili vicine o nella stessa direzione possono essere correlate, mentre quelle opposte possono essere anti-correlate.

Qui potete scaricare il materiale utile allo studio dell’analisi dei dati di metabolomica: DATA ANALYSIS

Una volta ottenute le variabili significative, dovremo capire quali metaboliti si “nascondono” dietro queste variabili, ad esempio, analizzando i dati NMR.

NB: L’analisi metabolomica prevede vari step e ognuno di questi porta con se una certa variabilità.
La standardizzazione delle procedure analitiche, di analisi e presentazione dei dati è di fondamentale importanza per poter “parlare” un linguaggio comune che permetta di confrontare i risultati di esperimenti diversi. In questo contesto, vi consiglio lo studio di “Proposed minimum reporting standards for chemical analysis” e “for data analysis” e l’articolo “Metabolite identification: are you sure? And how do your peers gauge your confidence?”

Laboratorio di Metabolomica

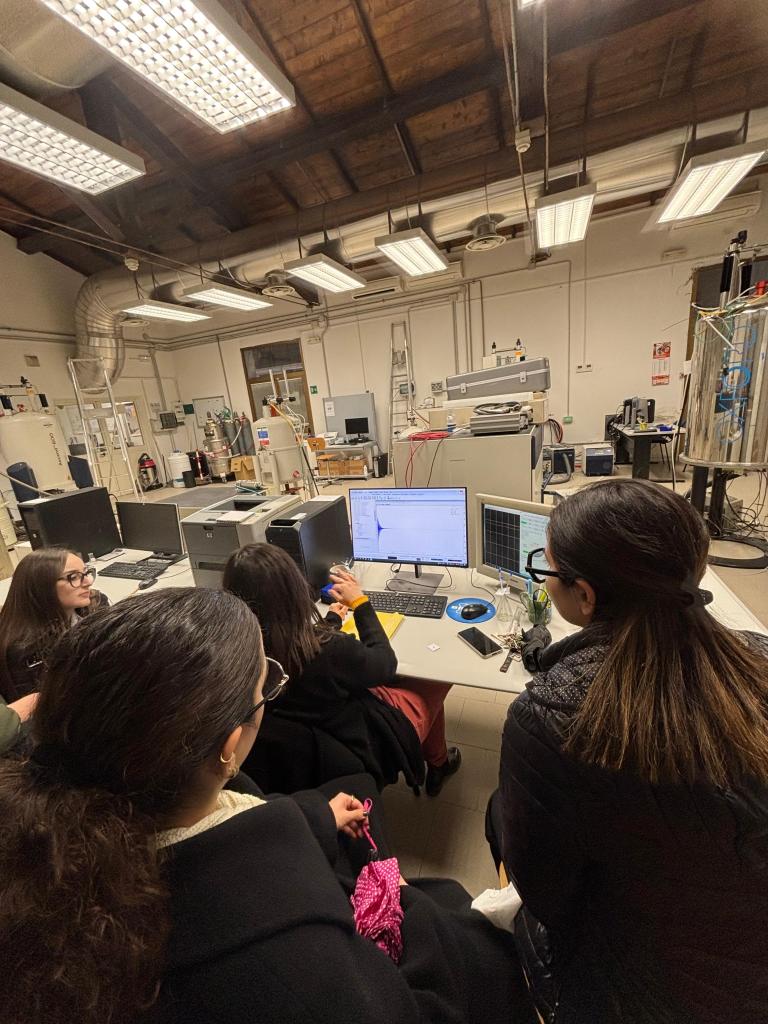
Nel corso della settimana scorsa si è tenuta la prima parte del laboratorio di Metabolomica.

Gli studenti del corso hanno preparato degli estratti e li hanno analizzati mediante NMR…ora la sfida è identificare quanti più metaboliti possibile prima della prossima esperienza di laboratorio in cui si misureranno con analisi statistica multivariata e 2D NMR!

Tecniche Analitiche in Metabolomica: NMR

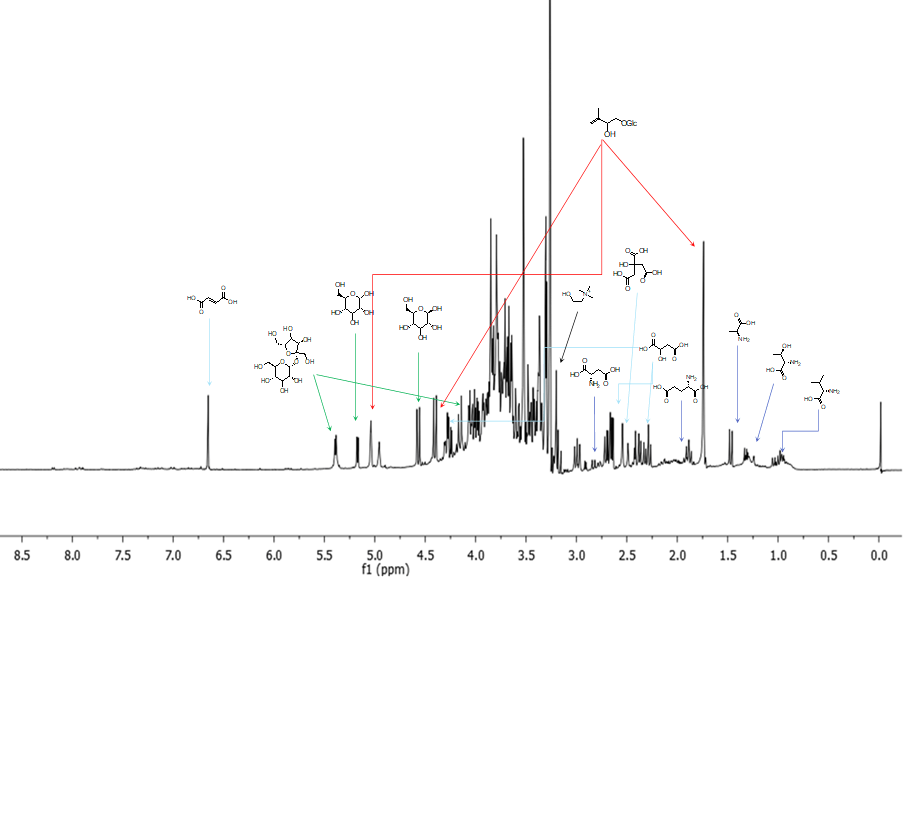
La Spettroscopia di Risonanza Magnetica Nucleare (NMR) è una tecnica che non ha rivali nell’ambito della caratterizzazione strutturale. Questa tecnica spettroscopica, che sfrutta le proprietà magnetiche dei nuclei di alcuni atomi, ci permette di avere informazioni fondamentali sui composti organici. Non tutti i nuclei sono attivi all’NMR, ma tra quelli attivi si annoverano il protone e l’isotopo 13C del carbonio ed è proprio grazie all’applicazione a questi nuclei che otteniamo informazioni strutturali fondamentali per poter identificare la struttura dei composti.

Da uno spettro protonico possiamo dedurre numerose informazioni: il chemical shift ci dà informazioni su quello che è l’intorno chimico, la molteplicità ci dà informazioni sul numero di protoni legati ai carboni vicini (con le costanti di accoppiamento che ci forniscono altre importanti informazioni strutturali), infine l’integrazione ci permette di avere informazioni di tipo quantitativo.
L’utilizzo di techinche 2D-NMR, inoltre, ci dà la possibilità di ricostruire l’intero scheletro delle molecole.
Tutte queste potenzialità sono estremamente utili in metabolomica. Abbiamo visto (e vedremo) in che modo possiamo applicare questa tecnica all’analisi metabolomica.

Intanto, cerchiamo di capire meglio il principio di base su cui poggia questa potentissima tecnicha.
Di seguito, due video che possono aiutarci. Il primo, prodotto dalla Bruker, il secondo da Sciencesketch.

Curiosi anche di sapere come è fatto lo strumento all’interno? Date un’occhiata qui!

Al link seguente è possibile scaricare il materiale di supporto allo studio:

Testi utili per ulteriori approfondimenti:

-D’Ischia “La chimica organica in laboratorio” Ed. Piccin
-Hesse “Metodi Spettroscopici in Chimica Organica”

(entrambi disponibili in biblioteca; in caso di indisponibilità, rivolgersi alla docente)

NMR-based metabolomics

Dall’analisi NMR di un campione si possono dedurre tante informazioni diverse. Ma come si effettua un’analisi metabolomica mediante NMR?

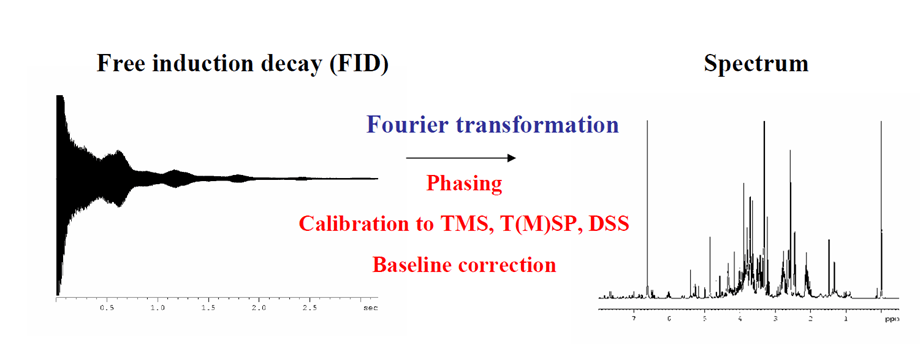
A partire dal materiale liofilizzato, si ottengono gli estratti con una procedura molto semplice che prevede l’estrazione diretta in solventi deuterati (necessari per l’analisi NMR). Questi estratti vengono analizzati, ottenendo gli spettri, che saranno poi processati: questo processing prevede l’apodizzazione, la fasatura, la calibrazione rispetto allo standard intetno e la correzione della linea di base

A questo punto si procede con l’integrazione. Questa è effettuata attraverso il processo di bucketing o binnig: lo spettro si divide in tanti segmenti di lunghezza definita (in genere 0.02 o 0.04 ppm) e si procede ad integrare l’area sotto la curva di ogni bucket. Si ottiene in questo modo una matrice di dati in cui le osservazioni sono i singoli campioni analizzati e le variabili sono i vari bucket, che assumeranno quindi il valore dell’area per quella parte dello spettro in ciascun campione (NB: le aree sono in genere normalizzate rispetto allo standard interno a alla total intensity).

La matrice di dati così ottenuta è sottoposta ad analisi statistica multivariata. Questa sarà utile ad estrarre le informazioni significative dal nostro set di dati.

Una volta identificati i segnali NMR significativi per la nostra analisi, è necessario “tradurre” questi segnali in metaboliti. Si opera a questo punto per step successivi.
Il primo passaggio è quello del confronto con la letteratura e con i database. A questo proposito, è necessario sottolineare come l’NMR sia una metodica altamente riproducibile. In ogni caso, se questa ricerca non ci dà la risposta sperata, si può optare per l’analisi NMR bidimensionale (2D NMR).I metodi 2D NMR più utilizzati in metabolomica sono brevemente descritti di seguito.

COSY (COrrelation SpecroscopY)

Esperimento 2D omocorrelato. Permette di rilevare correlazioni omonucleari 1H-1H tra protoni vicinali e geminali

TOCSY (TOtal Correlation SpecroscopY)

Esperimento 2D omocorrelato. Permette di rilevare sistemi di spin (il trasferimento di magnetizzazione è interrotto da carboni quaternari).

HSQC (Heteronuclear Single Quantum Coherence)

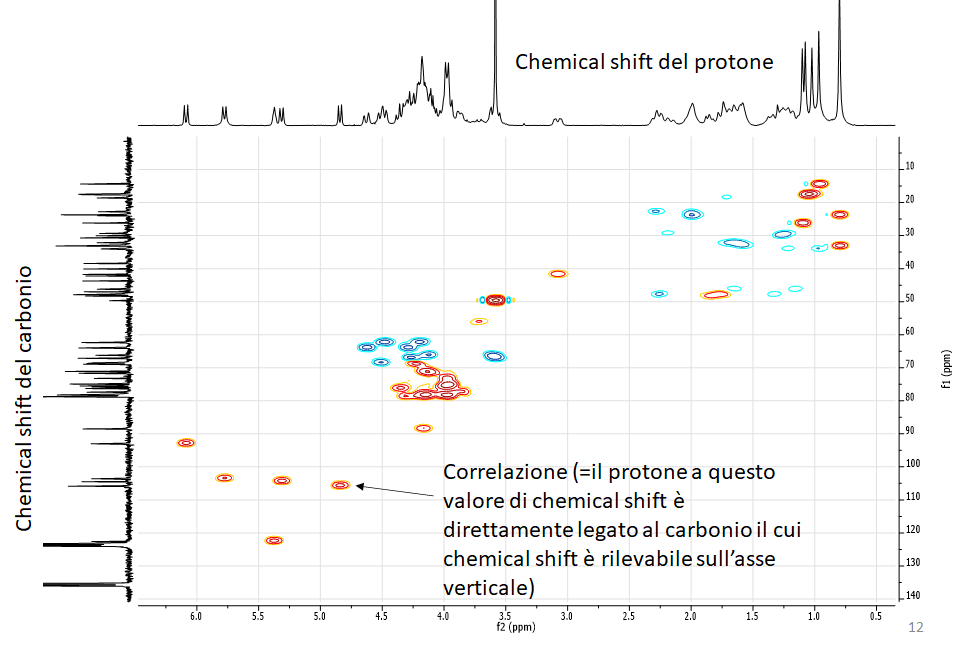
Esperimento 2D eterocorrelato. Permette di rilevare le correlazioni dirette protone-carbonio. Permette quindi di attribuire il valore di chemical shift del carbonio per ciascun carbonio protonato presente nell’estratto (o nella molecola, quando lo spettro si riferisce ad un composto puro)

H2BC (Heteronuclear 2 bond correlation)

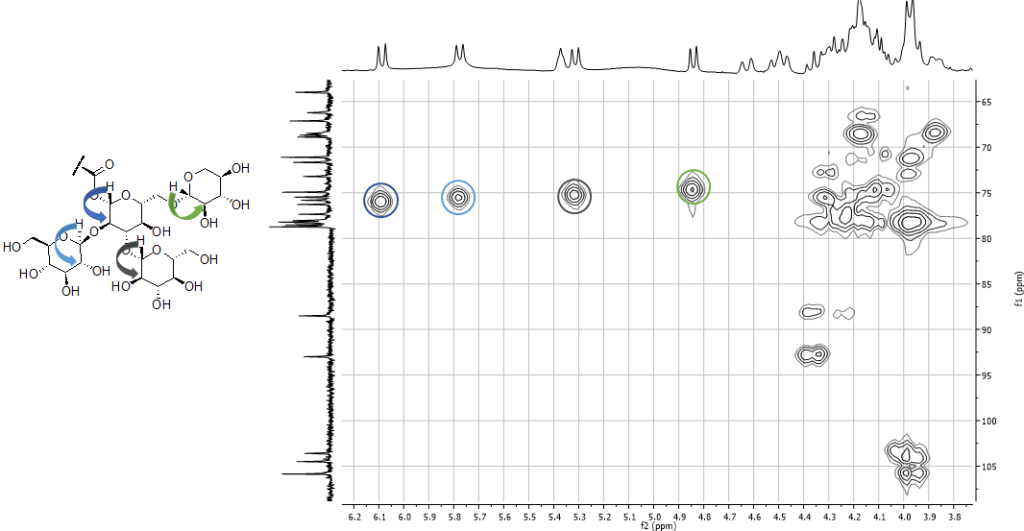
Esperimento 2D eterocorrelato. Permette di rilevare le correlazioni tra un protone e il carboni vicinale, a patto che quest’ultimo sia protonato.

Correlazioni selezionate indicate sullo spettro e sulla struttura con lo stesso colore

HMBC (Heteronuclear Multiple Bond Coherence)

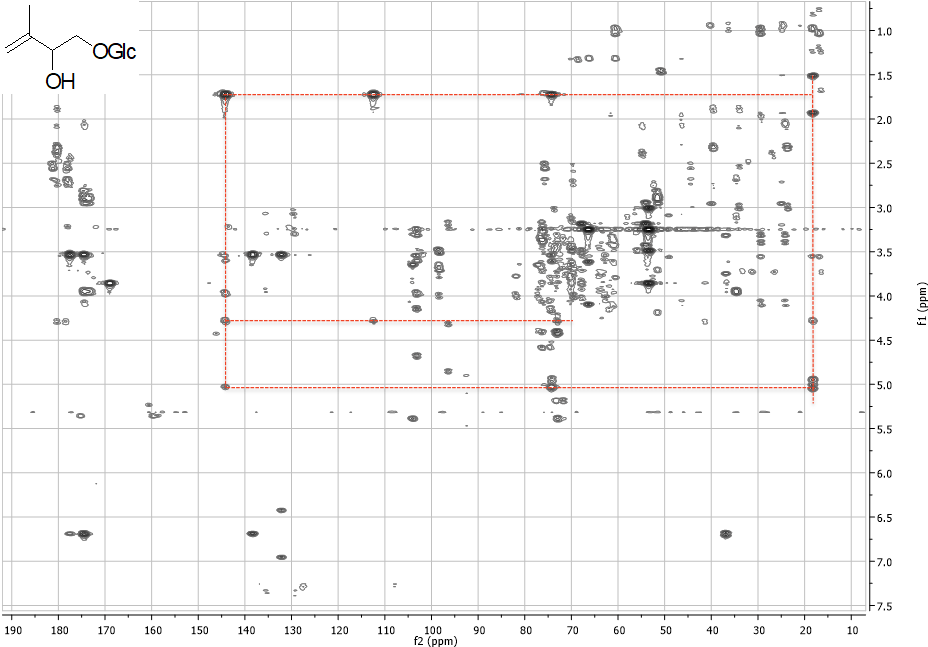
Esperimento 2D eterocorrelato. Permette di rilevare le correlazioni tra un protone e carboni distanti due, tre o quattro legami. Un esperimento alternativo è noto come CIGAR-HMBC.

Sono evidenziate le correlazioni del composto mostrato in alto a sinistra. Le altre correlazioni appartengono ad altre componenti dell’estratto.

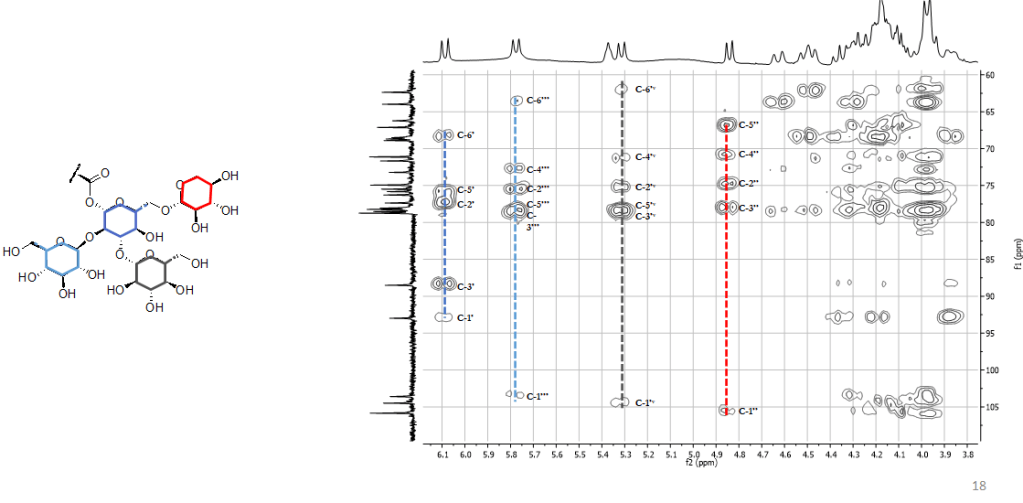
HSQC-TOCSY

Esperimento 2D eterocorrelato. Permette di rilevare sistemi di spin, che in questo caso includono sia i protoni sia i carboni.

Grazie alla combinazione delle informazioni che si ottengono dai diversi spettri 2D NMR, è possibile identificare i costituenti dell’estratto anche in miscela. Per metaboliti già noti, a questo punto sarà possibile confrontare i dati NMR con quelli riportati in letteratura o con quelli degli standard (a patto che siano acquisiti nello stesso solvente). Per i composti identificati per la prima volta, al fine di confermare la struttura, saranno necessari l’isolamento (che a questo punto sarà facilitato dalle informazioni preliminari in nostro possesso circa la struttura del composto) e la completa caratterizzazione strutturale mediante tecniche spettroscopiche.
Va infine ricordato che oltre ad identificare i componenti dell’estratto, è anche possibile quantificarli dato che l’ 1H NMR è una tecnica quantitativa (se gli spettri sono acquisiti con determinati parametri) e che è sufficiente in questo caso utilizzare uno standard interno a concentrazione nota.

Tecniche analitiche in Metabolomica: Spettrometria di Massa

Le due tecniche più utilizzate ad oggi per acquisire i dati in metabolomica sono senza dubbio la spettrometria di massa (MS) e la spettroscopia di risononanza magnetica nucleare (NMR).
La prima sfrutta la possibilità di generare e separare ioni in base al loro rapporto massa/carica. A lezione abbiamo visto che in realtà esistono tantissime applicazioni (ed “evoluzioni”) diverse di questa tecnica che la rendono particolarmente utile nell’analisi metabolomica. Il video seguente illustra, invece, il principio di base.

In una serie di video proposti dalla Waters, è possibile capire più a fondo il principio di funzionamente dell’ESI (Elettrospray ionization), che abbiamo visto essere insieme all’APCI e al MALDI (con tutte le variazioni sul tema viste a lezione) una delle tecniche di ionizzazione più diffuse quando la MS è utilizzata in metabolomica. Per quanto riguarda gli analizzatori, è possibile vedere come è fatto un quadrupolo.
Inoltre, è possibile approfondire la problematica della formazione di addotti, della formazione di specie con carica multipla, nonchè la questione dei picchi isotopici. Infine, viene affrontata la questione importantissima della risoluzione.

L’alta risoluzione è, in effetti, fondamentale nell’analisi metabolomica e, come abbiamo visto, anche l’applicazione della MS/MS aggiunge notevoli vantaggi in termini di determinazione dell’identità delle molecole. Nel seguente video è possibile seguire gli ioni nel loro cammino nel caso di un esperimento LC-MS/MS

Dal sito Bruker è possibile vedere come funziona un MALDI-TOF-TOF e da quello dell’Agilent come funziona un triplo quadrupolo associato ad un gas cromatografo o ad un HPLC/UPLC.

Le tecniche di HR-MS e MS/MS (o tandem MS) hanno notevolmente contribuito all’applicazione odierna di questa tecnica in campo metabolomico.
Inoltre, non va dimenticata la possibilità offerta dalle tecniche di imaging da un lato e dall’applicazione di tecnologie ancora più avanzate dall’altro.
Come non menzionare, allora, l’utilizzo della ion mobility mass spectrometry, che separa gli ioni non solo in base al rapporto massa/carica ma anche in funzione della loro grandezza e forma.

Le più recenti applicazioni della spettrometria di massa in metabolomica sono state trattate in una review recente “Advances in mass spectrometry-based metabolomics for investigation of metabolites” (Ren at al., RSC Advances, 2018).

Al link seguente è possibile scaricare il materiale di supporto allo studio:

« Older Entries